信息系统运行维护方案及对策研究——基于全生命周期视角的运维服务体系构建
一、引言
随着企业数字化转型的深入推进,信息系统已成为组织生产运营的核心支撑。系统上线并非终点,而是长期运行的起点。据行业统计,信息系统生命周期中约60%—80%的成本发生于运行维护阶段。如何构建科学、高效的运维方案,并针对常见问题提出有效对策,是保障系统稳定运行、持续释放业务价值的关键课题。
二、运维服务的目标与范围界定
2.1 运维目标
运维服务的核心目标可归纳为"稳、快、安、优"四个维度:稳——保障系统可用性达到约定服务水平;快——故障响应与恢复时效满足业务连续性要求;安——满足信息安全等级保护及数据合规要求;优——持续优化系统性能与用户体验,支撑业务演进。
2.2 服务范围
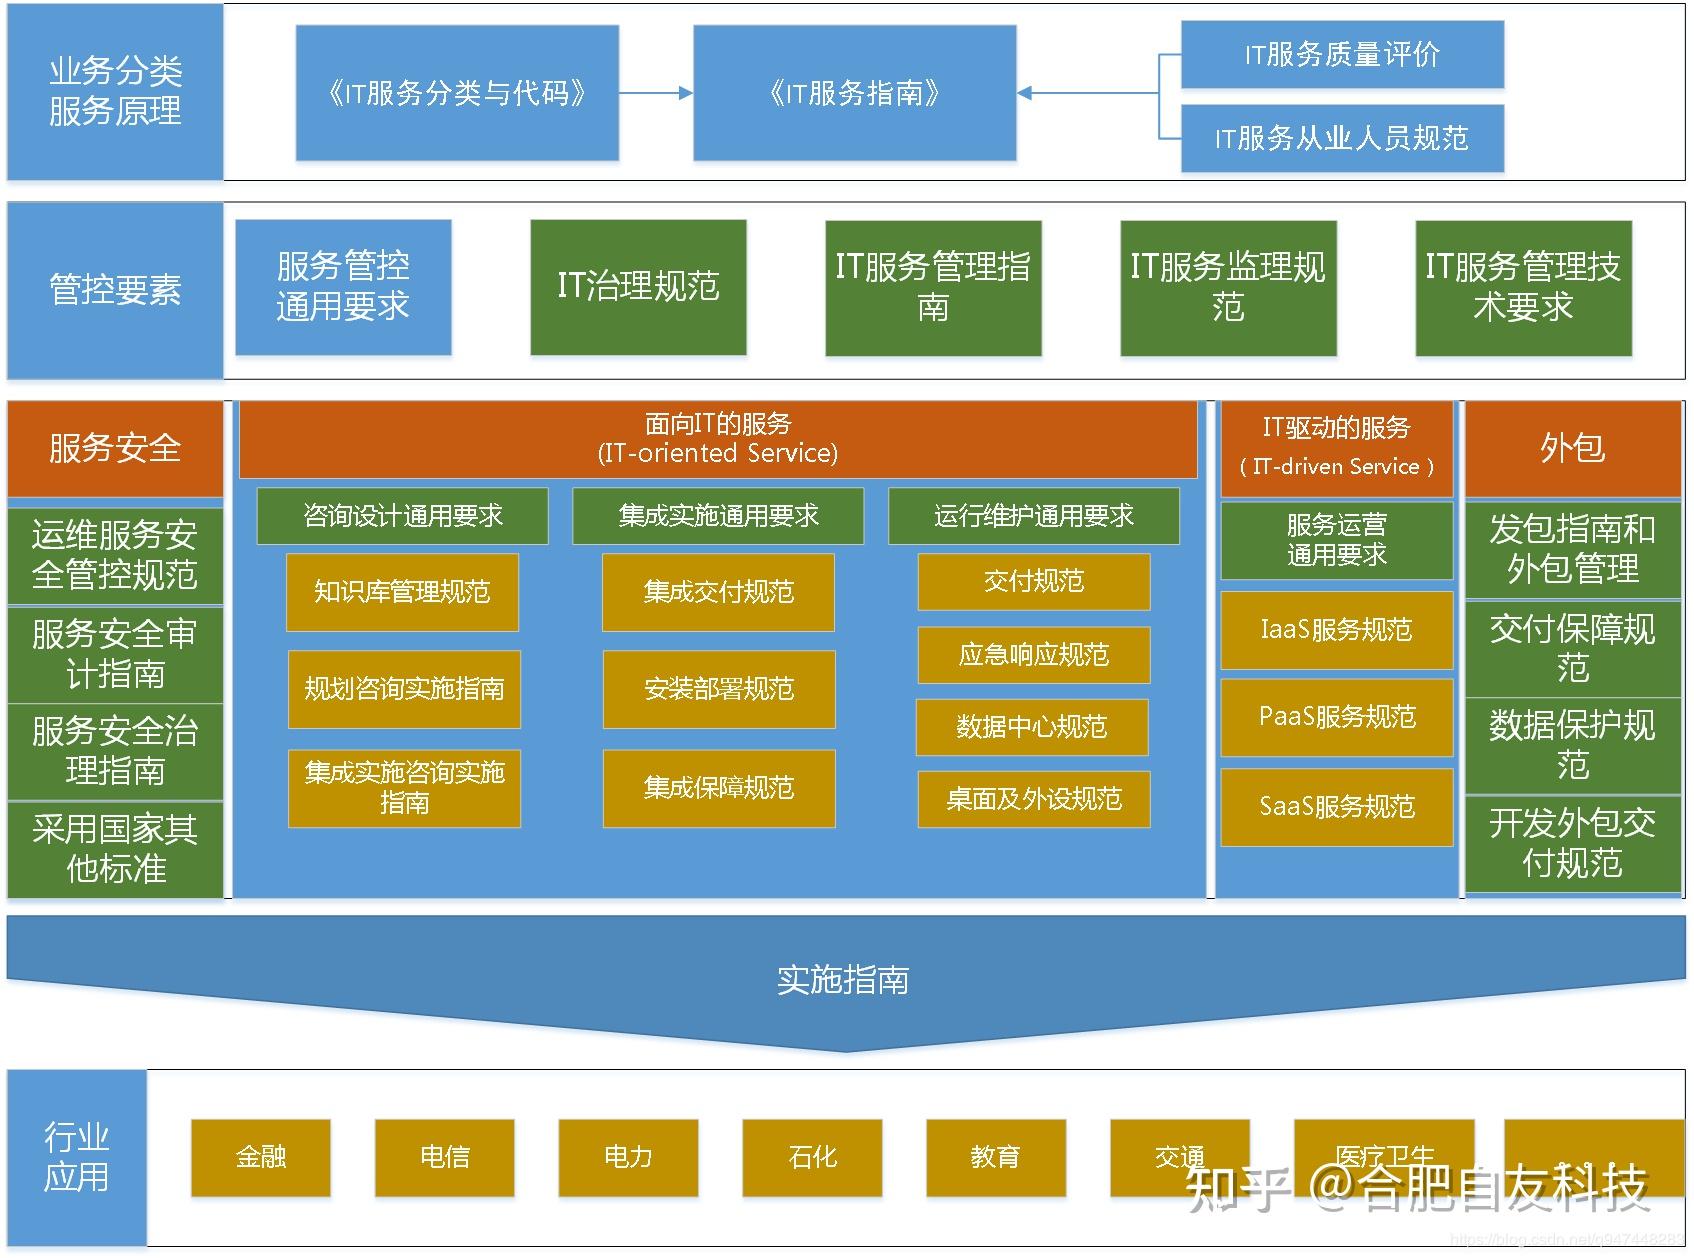
运维服务覆盖基础设施层(网络、服务器、存储、云资源)、平台层(操作系统、中间件、数据库)、应用层(业务系统、接口集成)以及安全层(漏洞管理、访问控制、日志审计),同时涵盖运维管理制度、流程与工具平台的建设和持续改进。
三、运维方案总体设计
3.1 运维服务体系框架
建议采用"人员+流程+工具+知识"四维联动的运维体系框架。人员方面,建立一线服务台、二线专业运维、三线厂商支持的 tiered 支持梯队;流程方面,以 ITIL/ISO 20000 为参照,规范事件管理、问题管理、变更管理、配置管理和发布管理;工具方面,部署监控告警、工单流转、自动化运维和资产管理平台;知识方面,建设运维知识库,沉淀故障预案与操作规范。
3.2 分级运维模式
根据系统重要级别实施差异化运维:核心系统实行7×24小时驻场或准驻场保障,关键指标实时监控、秒级告警;重要系统采用5×8小时常规运维加应急处置机制;一般系统采用远程巡检与按需响应模式。通过分级投入实现运维资源的合理配置。
3.3 服务级别管理(SLA)
明确各项服务指标并形成可考核的 SLA 协议,典型指标包括:系统可用率≥99.9%、一般事件30分钟内响应、重大故障2小时内恢复、变更成功率≥95%、客户满意度≥90分。SLA 指标应定期评审并随业务需求动态调整,相关考核结果与运维团队绩效挂钩。
3.4 监控与预警体系
构建覆盖"基础资源—中间件—应用—业务"的分层监控体系。基础层监控 CPU、内存、磁盘、网络等指标;应用层监控服务状态、响应时间、错误率;业务层设置关键业务量阈値告警。通过统一告警平台实现告警收敛与分级推送,并依托容量趋势分析提前识别资源瓶颈,实现从"被动救火"向"主动预防"转变。
3.5 备份与灾难恢复
制定分级备份策略:核心数据每日全量加实时增量备份,重要数据定期全量备份。建立同城或异地灾备环境,定期开展恢复演练,一般每年不少于两次。明确 RPO(恢复点目标)与 RTO(恢复时间目标),并针对勒索病毒等高危场景制定专项应急预案。
3.6 安全管理运维
落实账号权限最小化管理,定期清理僵尸账号;建立漏洞扫描与补丁管理机制,高危漏洞限期修复;启用操作审计与日志留存,满足合规要求;对运维人员实行操作双人复核与关键操作审批,防范内部风险。
3.7 变更与发布管理
严格执行变更分级审批制度:常规变更走标准流程,重大变更须经变更评审委员会评估并制定回滚方案。推广灰度发布与蓝绿部署策略,降低变更风险窗口。变更后48小时内实施专项观察,确保遗留问题及时发现。
四、运维过程中的主要问题与对策
4.1 故障被动响应、根因分析不足
问题表现:运维团队长期处于"救火"状态,同类故障反复发生。
对策:建立问题管理闭环机制,对重复性事件强制升级为问题单,运用根因分析(RCA)方法定位深层原因;依托运维知识库沉淀解决方案与常见问题手册;推动研发团队参与系统性缺陷修复,定期输出故障分析报告并跟踪改进项落实情况。
4.2 运维人员技能断层与流动风险
问题表现:关键岗位依赖个别骨干,人员变动导致服务中断风险。
对策:实行角色 AB 角备份机制,关键操作形成标准化作业指导书(SOP);建立分层培训体系与认证激励;推进运维自动化降低人为依赖;通过知识管理实现经验资产化,减少机构知识随人员流失的风险。
4.3 变更引发的次生故障
问题表现:变更操作是生产事故的高发诱因。
对策:推行变更风险评估清单制度,明确高风险变更的复核与演练要求;强化测试环境与生产环境的一致性管理;扩大自动化发布覆盖面,减少手工操作;设置变更封网期,限制业务高峰时段的变更窗口。
4.4 监控告警噪声大、有效性低
问题表现:告警数量过多导致运维人员疲劳与漏报。
对策:实施告警分级与收敛策略,区分"需要立即处置"与"仅需记录"的告警;建立告警规则定期评审机制,清理长期无效噪音;引入异常检测等智能分析手段,提升告警准确率。
4.5 数据备份有效性验证缺失
问题表现:备份任务看似正常,但恢复成功率存疑。
对策:建立定期恢复抽验制度,除灾备演练外,以抽样方式验证常规备份可恢复性;监测备份作业状态与存储容量,多线程提升大体量系统的备份效率,保障 RPO 达标。
4.6 运维价值难以量化体现
问题表现:运维工作被视为成本中心,缺少价值输出的语言。
对策:基于事件数据与业务指标交叉分析,量化故障对业务的影响及运维干预带来的可用性提升;建立运维服务报告制度,定期向管理层呈报服务质量与改进成效;对系统可靠性开展持续 monitoring 并应用于重要迭代规划,将运维经验向前反馈至系统和流程的设计优化。
五、
信息系统运行维护是一项体系化、持续性工程。科学的运维方案应当立足服务级别目标,以分级管控和主动预防为主线,系统推进人员、流程、工具与知识四位一体建设;有效的对策则需聚焦故障根因治理、变更风险控制、告警治理与知识传承等真实痛点。唯有将运维从"技术保障"上升为"服务治理",方能以可控的成本支撑信息系统长期稳定高效运行,持续为业务创造价值。
如若转载,请注明出处:http://www.umkmifr.com/product/46.html
更新时间:2026-11-01 07:56:57